Healthcare
Classement des dossiers médicaux et indexation, automatisés
Dossiers médicaux lus, renommés par pathologie et classés automatiquement, les données de santé restant dans votre propre espace de stockage.
Obtenir une proposition gratuite
Dites-nous ce dont vous avez besoin. Un consultant vous répond sous un jour ouvré.
01
Des dossiers médicaux qui se classent tout seuls
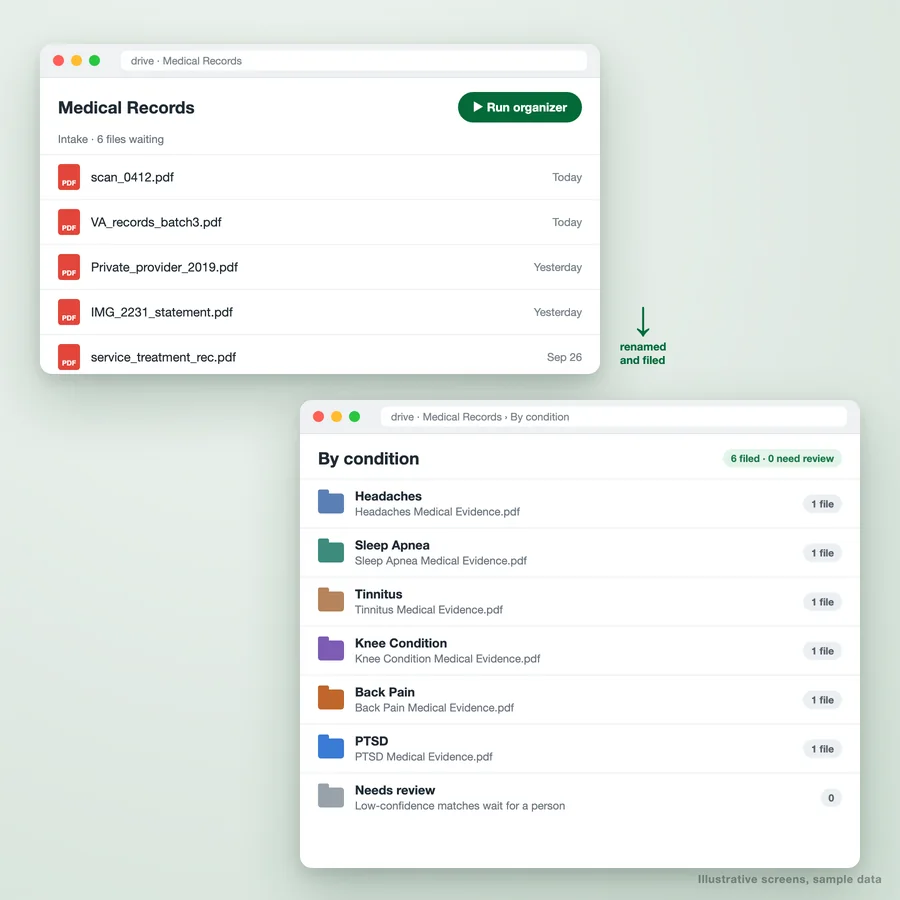
Consultants en demandes d’indemnisation, cabinets d’avocats et cabinets médicaux finissent tous avec le même dossier : des centaines de PDF scannés nommés scan_0412.pdf, venant des systèmes de la VA, de prestataires privés et de télécopieurs. Quelqu’un ouvre chaque fichier, détermine de quoi il s’agit, le renomme et le glisse au bon endroit. C’est lent, les erreurs sont faciles, et chaque fichier contient des informations de santé protégées. Le classement des dossiers médicaux mérite mieux.
Nous automatisons cette étape. L’équipe dépose les dossiers dans un seul dossier d’entrée et appuie sur un bouton. Chaque PDF est lu, rattaché à une pathologie, un prestataire ou une date, renommé selon un modèle cohérent comme Headaches Medical Evidence, puis déplacé dans le dossier correspondant. Tout ce dont le système n’est pas sûr attend dans un dossier de vérification qu’une personne s’en occupe.
02
Ce que fait l’outil de classement
Il lit chaque document
Le texte est extrait de chaque PDF, y compris les scans : c’est le contenu qui décide de la destination, pas le nom de fichier d’origine.
Il l’associe à une pathologie
Les documents sont rattachés à votre propre liste de pathologies, de prestataires ou de motifs de demande : les catégories sont les vôtres, pas une taxonomie générique.
Il renomme de façon cohérente
Chaque fichier suit un seul modèle de nommage, par exemple la pathologie suivie de "Medical Evidence", pour que chacun retrouve tout.
Il range dans le bon dossier
Le PDF renommé passe du dossier d’entrée au dossier de sa pathologie, créé automatiquement la première fois qu’il est nécessaire.
Il met de côté ce qui est incertain
Les correspondances peu fiables vont dans un dossier À vérifier, avec la raison, au lieu d’être rangées discrètement au mauvais endroit.
Il s’exécute quand vous le décidez
Un bouton de lancement pour l’équipe : rien ne bouge dès qu’un fichier est déposé. Une exécution planifiée est aussi possible si vous préférez.
03
Qui l’utilise
04
Comment nous le mettons en place
Définir les catégories et les noms
Votre liste de pathologies ou de types de documents, et le modèle de nommage exact que chaque fichier doit suivre.
Construire dans votre espace
L’outil fonctionne dans votre propre compte Google Workspace ou Microsoft 365, sous votre BAA. Les dossiers n’en sortent jamais.
Tester sur des fichiers anonymisés
Nous ajustons la correspondance uniquement sur des documents anonymisés ou synthétiques, jamais sur de vrais dossiers patients, et vous montrons les résultats.
Livrer avec un bouton de lancement
L’équipe reçoit un bouton de lancement et un guide court. Le script, les dossiers et les données vous appartiennent.
05
Questions sur le classement automatisé des dossiers médicaux
Où le traitement a-t-il lieu ?
Que se passe-t-il quand un document concerne plusieurs pathologies ?
Peut-il lire des documents scannés ou manuscrits ?
Pourquoi un bouton plutôt qu’une exécution au dépôt ?
Combien de temps faut-il pour la mise en place ?
Envoyez-nous votre arborescence, pas vos fichiers
Décrivez comment les dossiers arrivent et comment vous souhaitez les organiser. Nous reviendrons vers vous avec le fonctionnement de l’outil et ce qu’implique sa mise en place.
Merci de n’envoyer aucun dossier patient. Une description ou un échantillon anonymisé suffit.
Fait partie de notre dossier Automatisation des cabinets de santé. Pour commencer : automatisation des workflows en santé.
Automatisation des cabinets de santé
En savoir plus : automatisation des workflows en santé
Automatisation des workflows IA, conçue et exploitée pour vous
Des workflows IA qui lisent, décident et agissent dans vos systèmes, conçus puis exploités pour vous.
Dental Appointment Reminders That Cut No-Shows and Fill the Chair
Automated dental appointment reminders over WhatsApp and SMS that confirm visits, fill recall gaps and cut no-shows, using the tools your clinic already runs.
Étude de cas : Portail de soumission pour cliniciens (portail PTC)
Indicateur Avant Après Erreurs de saisie Élevées Nettement réduites Temps de saisie des cliniciens 10–15 min/jour < 3 min/jour Effort de revue administrative Important Léger et structuré...
Link EMR/EHR Data with Insurance Claims Through Automation
Link EMR/EHR Data with Insurance Claims Through Automation Healthcare providers and insurers often face the challenge of fragmented data. While Electronic Medical Records (EMR) and Electronic...
Logiciel de gestion de cabinet ABA, conçu pour votre clinique
Séances, autorisations, dossiers et rapports pour les cliniques ABA, dans un seul système qui vous appartient.